Regularmente nos encontramos con sitios cuyos menús muestran una decena de secciones, pero donde encontrar una página específica se convierte en un verdadero laberinto. Antes de hablar de rediseño o SEO, la pregunta inicial es más simple: ¿cómo leer la estructura de un sitio web existente para entender qué contiene, qué falta y qué problemas presenta tanto a los visitantes como a los robots de exploración?
Archivo robots.txt y sitemap XML: los dos primeros reflejos de exploración
Cuando queremos entender la estructura de un sitio web, no comenzamos haciendo clic en el menú. Abrimos dos archivos accesibles añadiendo /robots.txt y /sitemap.xml a la URL raíz.
El robots.txt indica qué secciones están bloqueadas para los robots de búsqueda. Una carpeta entera oculta (por ejemplo /staging/ o /archive/) a menudo señala contenidos abandonados o una migración incompleta. El sitemap XML, por su parte, lista las páginas que el propietario del sitio considera indexables. Comparar el sitemap con el menú de navegación revela las discrepancias: páginas huérfanas ausentes del menú, URL antiguas aún declaradas, categorías vacías.
Se puede consultar el sitio Actu Web en detalle para observar un ejemplo concreto de sitemap estructurado por secciones temáticas, lo que proporciona una lectura rápida de la organización editorial.
Este paso toma unos minutos y proporciona un mapa bruto del contenido antes de cualquier análisis profundo.
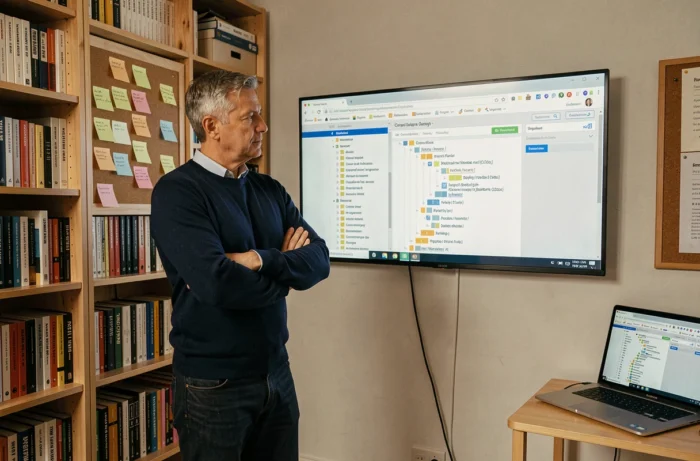
Exploración por robots IA: GPTBot, ClaudeBot y las nuevas reglas de acceso
Desde 2023, los registros de servidores han comenzado a registrar visitas de robots que no existían hace unos años: GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot, Applebot y OAI-SearchBot. Estos agentes no buscan indexar páginas para un motor clásico. Recogen contenido para entrenar modelos de lenguaje o alimentar respuestas conversacionales.
Distinguir estos robots de los crawlers clásicos como Googlebot se ha convertido en una tarea en sí misma. Las opciones de filtrado pasan por el robots.txt (directrices específicas de User-agent), pero también por reglas de CDN, WAF o restricciones de IP para un control más granular.
El archivo llms.txt, una capa de estructura fuera de HTML
Desde 2025, varios guías recomiendan colocar un archivo llms.txt en la raíz del sitio. Este archivo lista las URL prioritarias y las políticas de acceso para cada agente IA. Algunos añaden resúmenes de contenido por sección.
El objetivo es facilitar una exploración dirigida por los modelos de lenguaje, donde el sitemap XML sigue estando orientado a los motores de búsqueda tradicionales. Se pasa de una lógica de “indexación para Google” a una lógica de “visibilidad multi-agentes” que también abarca la búsqueda conversacional.
Las opiniones varían sobre la adopción real de este archivo por parte de los diferentes agentes, pero el principio de segmentar los accesos según el tipo de robot se está imponiendo progresivamente como una buena práctica.
Sitios en Single Page Application: la trampa del contenido invisible
Un sitio construido en SPA (React, Vue, Angular) carga todo su contenido a través de JavaScript del lado del cliente. Visualmente, la navegación parece fluida. Para un robot de exploración, el resultado puede ser una página casi vacía si el renderizado del servidor (SSR o prerenderizado) no está configurado.
Sin renderizado del lado del servidor, la mayoría del contenido de una SPA permanece invisible para los crawlers. Googlebot ejecuta JavaScript, pero con un retraso y limitaciones. Los robots IA, por su parte, no todos tienen esta capacidad.
Al analizar la estructura de un sitio SPA, es necesario verificar tres puntos concretos:
- ¿El código fuente bruto (Ctrl+U en el navegador) contiene el texto visible en pantalla, o solo etiquetas vacías y llamadas a JavaScript?
- ¿Las URL internas generan páginas distintas del lado del servidor, o todo pasa por un único punto de entrada con fragmentos (#)?
- ¿El sitemap XML referencia todas las rutas de la aplicación, incluidas las subpáginas dinámicas?
Si el código fuente está vacío y el sitemap no cubre las rutas internas, el sitio tiene un problema de exploración que afecta tanto al SEO clásico como a la visibilidad ante los agentes IA.
Navegación móvil y profundidad de clic: medir la accesibilidad real del contenido
En desktop, un menú desplegable de dos niveles da acceso a varias decenas de páginas con un clic. En móvil, este mismo menú se transforma en acordeón o en hamburguesa, y cada nivel añade una interacción táctil. La profundidad de clic percibida en móvil es a menudo el doble que en desktop.
Para evaluar la estructura desde el punto de vista del usuario, contamos el número de toques necesarios para alcanzar las páginas más consultadas. Más allá de tres toques desde la página de inicio, la tasa de abandono aumenta notablemente. También es una señal para los motores de búsqueda: una página enterrada a cinco niveles de profundidad recibe menos presupuesto de rastreo.
Enlazado interno y enlaces contextuales
El menú principal no es suficiente para hacer accesibles todas las páginas. Los enlaces integrados en el cuerpo de los artículos o las fichas de productos constituyen el enlazado interno contextual. Esta red de enlaces internos cumple dos funciones:
- Guía al visitante hacia contenidos complementarios sin tener que volver al menú, lo que reduce la profundidad de navegación efectiva
- Distribuye la autoridad SEO entre las páginas, señalando a los robots cuáles páginas están temáticamente relacionadas
- Ofrece a los agentes IA caminos de exploración adicionales hacia contenidos que no siempre figuran en el sitemap
Analizar el enlazado interno de un sitio equivale a mapear sus conexiones reales, no solo su estructura teórica.
Auditar un sitio web moderno: por dónde comenzar concretamente
Recapitulamos la secuencia de campo: abrir el robots.txt para identificar bloqueos, leer el sitemap XML para listar las páginas declaradas, verificar la presencia de un archivo llms.txt, probar el renderizado del lado del servidor en algunas páginas clave y luego contar la profundidad de clic en móvil. Estas cinco verificaciones cubren los ángulos que la mayoría de las auditorías pasan por alto, en particular el acceso de los robots IA al contenido y el comportamiento real de los sitios en JavaScript.
La exploración de un sitio web ya no se limita a su navegación visible. La estructura que importa es aquella que los robots, clásicos o conversacionales, logran leer efectivamente.