We komen regelmatig websites tegen waarvan het menu een tiental rubrieken toont, maar waar het vinden van een specifieke pagina een obstakelparcours lijkt. Voordat we het hebben over herontwerp of SEO, is de beginvraag eenvoudiger: hoe lees je de structuur van een bestaande website om te begrijpen wat deze bevat, wat ontbreekt en wat problemen oplevert voor bezoekers en crawlers.
robots.txt en sitemap XML: de eerste twee verkenningsreflexen
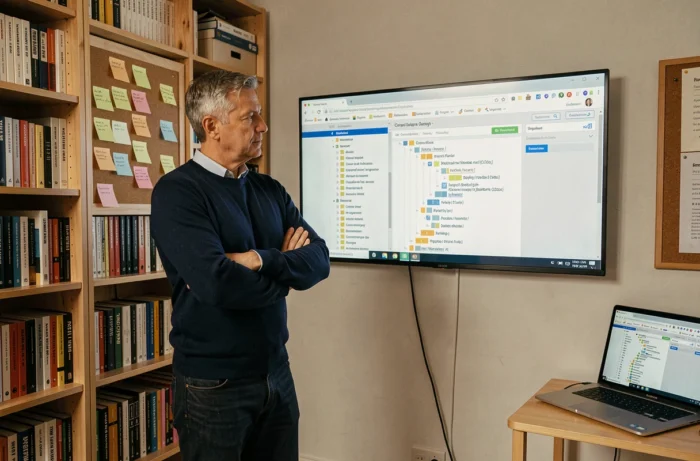
Wanneer je de structuur van een website wilt begrijpen, begin je niet met klikken in het menu. Je opent twee bestanden door /robots.txt en /sitemap.xml toe te voegen aan de root-URL.
Het robots.txt-bestand geeft aan welke secties zijn geblokkeerd voor zoekrobots. Een hele map die verborgen is (bijvoorbeeld /staging/ of /archive/) duidt vaak op verlaten inhoud of een onvoltooid migratieproces. De sitemap XML daarentegen, somt de pagina’s op die de eigenaar van de site beschouwt als indexeerbaar. Het vergelijken van de sitemap met het navigatiemenu onthult de discrepanties: weespagina’s die ontbreken in het menu, oude URL’s die nog steeds zijn opgegeven, lege categorieën.
Je kunt de site Actu Web in detail bekijken voor een concreet voorbeeld van een sitemap gestructureerd per thematische rubrieken, wat een snelle lezing van de redactionele organisatie mogelijk maakt.
Deze stap kost enkele minuten en biedt een ruwe kaart van de inhoud voordat je een diepgaande analyse uitvoert.
Verkenning door AI-robots: GPTBot, ClaudeBot en de nieuwe toegangsregels
Sinds 2023 registreren serverlogs bezoeken van robots die enkele jaren geleden niet bestonden: GPTBot (OpenAI), ClaudeBot (Anthropic), PerplexityBot, Applebot en OAI-SearchBot. Deze agents proberen geen pagina’s te indexeren voor een traditionele zoekmachine. Ze verzamelen inhoud om taalmodellen te trainen of conversatie-antwoorden te voeden.
Het onderscheiden van deze robots van klassieke crawlers zoals Googlebot is een op zichzelf staande taak geworden. De filteropties verlopen via het robots.txt-bestand (specifieke User-agent richtlijnen), maar ook via CDN-regels, WAF of IP-beperkingen voor een meer granulaire controle.
Het llms.txt-bestand, een laag van structuur buiten HTML
Sinds 2025 raden verschillende gidsen aan om een llms.txt-bestand in de root van de site te plaatsen. Dit bestand somt de prioritaire URL’s en de toegangsbeleid voor elke AI-agent op. Sommigen voegen samenvattingen van inhoud per sectie toe.
Het doel is om een gerichte verkenning door taalmodellen te vergemakkelijken, terwijl de sitemap XML gericht blijft op traditionele zoekmachines. We gaan van een “indexatie voor Google”-logica naar een “multi-agent zichtbaarheid“-logica die ook de conversatiezoekopdracht dekt.
De reacties variëren over de werkelijke adoptie van dit bestand door de verschillende agents, maar het principe om de toegang te segmenteren op basis van het type robot wordt geleidelijk aan een goede praktijk.
Sites in Single Page Application: de val van onzichtbare inhoud
Een site die is gebouwd als SPA (React, Vue, Angular) laadt al zijn inhoud via JavaScript aan de clientzijde. Visueel lijkt de navigatie soepel. Voor een crawler kan het resultaat een bijna lege pagina zijn als de server-side rendering (SSR of pre-rendering) niet is geconfigureerd.
Zonder server-side rendering blijft het grootste deel van de inhoud van een SPA onzichtbaar voor crawlers. Googlebot voert JavaScript uit, maar met een vertraging en beperkingen. De AI-robots hebben niet allemaal deze capaciteit.
Wanneer je de structuur van een SPA-site analyseert, moet je drie concrete punten controleren:
- Bevat de ruwe broncode (Ctrl+U in de browser) de tekst die zichtbaar is op het scherm, of alleen lege tags en JavaScript-aanroepen?
- Genereren de interne URL’s aparte pagina’s aan de serverzijde, of gaat alles via een enkel toegangspunt met fragmenten (#)?
- Verwijst de sitemap XML naar alle routes van de applicatie, inclusief dynamische subpagina’s?
Als de broncode leeg is en de sitemap de interne routes niet dekt, heeft de site een verkenningsprobleem dat zowel de klassieke SEO als de zichtbaarheid voor AI-agents beïnvloedt.
Mobiele navigatie en klikdiepte: de werkelijke toegankelijkheid van de inhoud meten
Op desktop geeft een dropdownmenu met twee niveaus toegang tot meerdere tientallen pagina’s met één klik. Op mobiel verandert hetzelfde menu in een accordeon of hamburger, en elk niveau voegt een aanrakingselement toe. De waargenomen klikdiepte op mobiel is vaak het dubbele van die op desktop.
Om de structuur vanuit het perspectief van de gebruiker te evalueren, tellen we het aantal taps dat nodig is om de meest bezochte pagina’s te bereiken. Meer dan drie taps vanaf de homepage leidt tot een merkbare toename van het bouncepercentage. Dit is ook een signaal voor zoekmachines: een pagina die vijf niveaus diep is begraven, ontvangt minder crawlbudget.
Interne linkstructuur en contextuele links
Het hoofdmenu is niet voldoende om alle pagina’s toegankelijk te maken. De links die in de body van artikelen of productbladen zijn geïntegreerd, vormen de contextuele interne linkstructuur. Dit netwerk van interne links vervult twee functies:
- Het leidt de bezoeker naar aanvullende inhoud zonder terug te gaan naar het menu, wat de effectieve navigatiediepte vermindert
- Het verdeelt de SEO-autoriteit tussen de pagina’s, door aan de robots aan te geven welke pagina’s thematisch zijn gelinkt
- Het biedt AI-agents extra verkenningspaden naar inhoud die niet altijd in de sitemap staat
Het analyseren van de interne linkstructuur van een site komt neer op het in kaart brengen van zijn werkelijke verbindingen, niet alleen zijn theoretische boomstructuur.
Een moderne website auditen: waar concreet te beginnen
We herhalen de praktische volgorde: open het robots.txt-bestand om blokkades te identificeren, lees de sitemap XML om de opgegeven pagina’s op te sommen, controleer de aanwezigheid van een llms.txt-bestand, test de server-side rendering op enkele belangrijke pagina’s en tel de klikdiepte op mobiel. Deze vijf controles dekken de hoeken die de meeste audits verwaarlozen, vooral de toegang van AI-robots tot de inhoud en het werkelijke gedrag van sites in JavaScript.
De verkenning van een website beperkt zich niet langer tot de zichtbare navigatie. De structuur die telt, is die welke de robots, klassiek of conversatiegericht, daadwerkelijk kunnen lezen.